はじめに
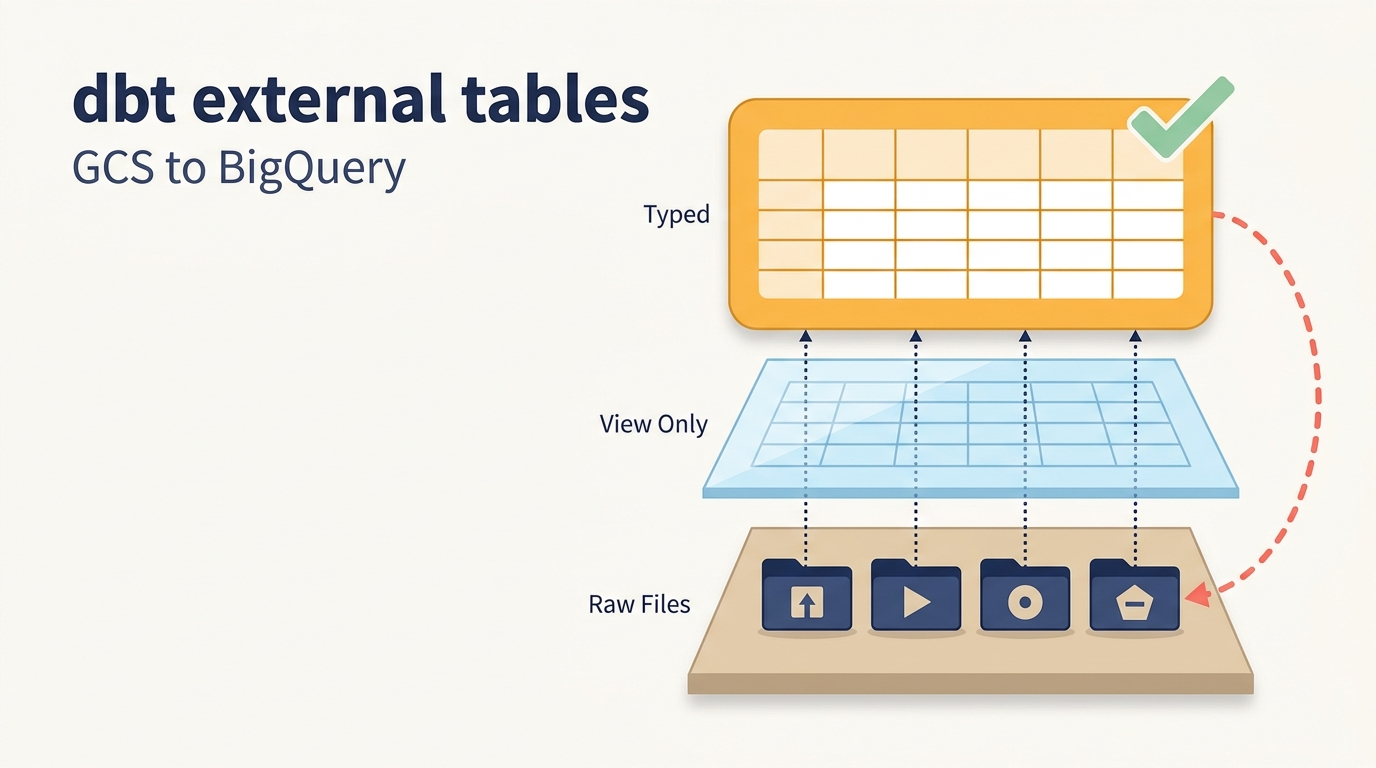
GCS に置いたファイルを BigQuery から読むときは、external table を使います。データを BigQuery の中へコピーせず、GCS のファイルをそのままテーブルとして扱う仕組みです。
私の構成では、GCS に NDJSON で置き、Source の層で型を付けて読み、Lake の層で重複を除きながら書き込んでいます。NDJSON は 1 行に 1 レコードを書く形式で、external table で JSON を読むときはこの形にします。
本記事では、GCS に置くファイルの形から、external table の作り方、dbt の層の分け方、そして注意点までを順に書きます。題材にするのは気象データを取り込んでいるパイプラインです。
本記事のまとめ
- GCS に置くのは NDJSON。Hive パーティションは取得日の 1 段だけに絞る。
- 私のリポジトリでは external table を Terraform で定義していない。Job の起動時にスクリプトで作る。
- merge の unique_key に取得日を入れるかどうかで、1 行に収束するか履歴が積み上がるかが変わる。
- dbt が毎日成功していても、入力が止まっていることがある。生死は層ごとに見る。
GCSに置くファイルの形とパスの決め方
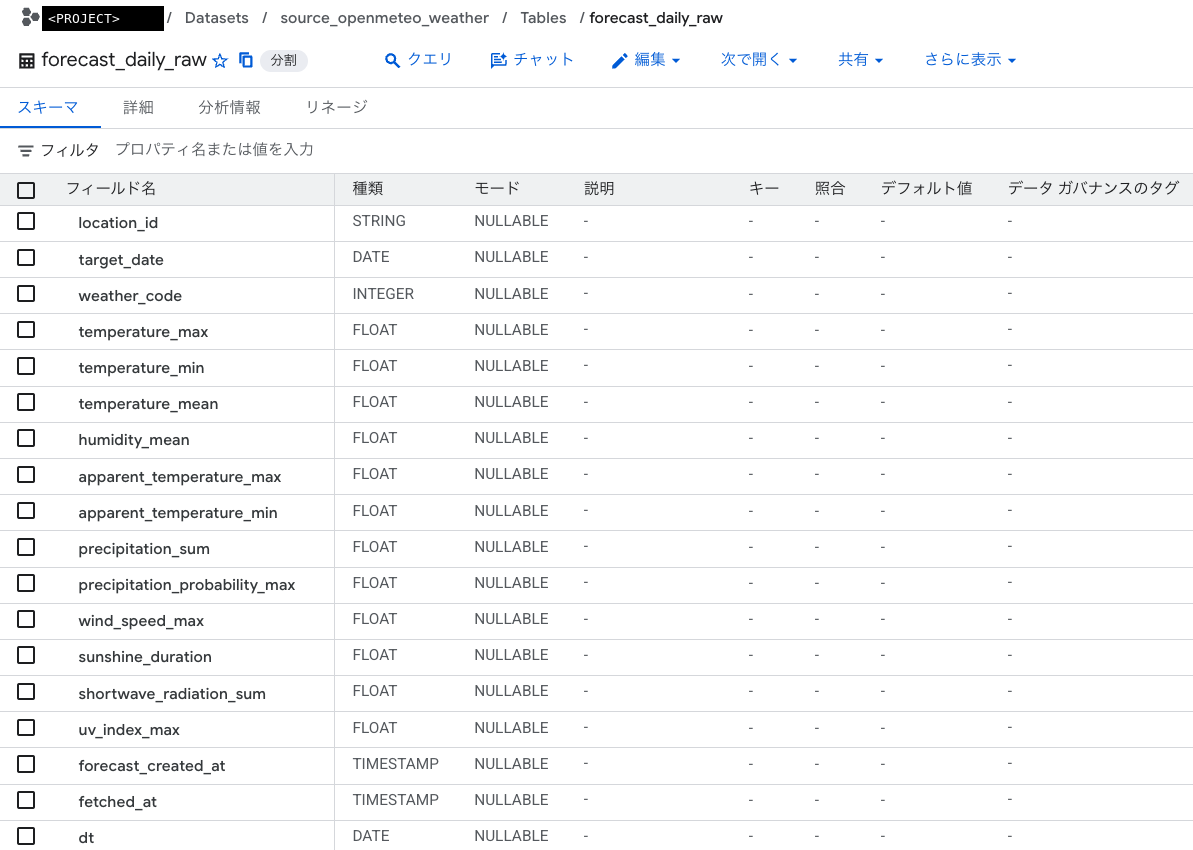
ファイルは NDJSON、パーティションは取得日の 1 段だけにしてください。ここを後から直すと、external table の定義と GCS のパスの両方を作り直すことになります。
Hive パーティションは、GCS のディレクトリ名に dt=2026-10-11 のように列名と値を書いておくと、BigQuery がそれをテーブルの列として扱ってくれる仕組みです。日付で絞り込んだときに、読むファイルをディレクトリ単位で減らせます。
決まりが 2 つあります。
- パスの接頭辞は、パーティションの直前で終わらせる。
hive_partition_uri_prefixに渡す接頭辞と、dt=のディレクトリの間に、データ種別のディレクトリを挟めない。 - パーティションの列名を、ファイルの中のカラムと重複させない。重複すると、external table の作成そのものが失敗する。
1 つ目は、種別ごとにディレクトリを切りたくなったときに引っかかります。接頭辞を raw/ のままにすると、間に種別の階層が挟まるからです。種別ごとに external table を分けるなら、接頭辞を種別の階層まで伸ばします。1 つの external table に複数の種別をまとめるなら、ファイル名かレコードの中のカラムで判別します。接頭辞の決まりは公式ドキュメントの制限事項にあります。
2 つ目は、dt を JSONL の中にも書いてしまうと起きます。取得日はパスだけに出し、ファイルの中には書きません。
| パス構成 | 結果 |
<テーブル名>/dt=2026-10-11/*.jsonl | 通る。接頭辞がパーティションの直前で終わっている |
raw/<種別>/dt=2026-10-11/*.jsonl で接頭辞が raw/ | 通らない。接頭辞とパーティションの間に階層がある |
<テーブル名>/dt=2026-10-11/*.jsonl で JSONL にも dt がある | 通らない。パーティションの列名が重複している |
external tableは起動時にスクリプトで作る
私のリポジトリでは、external table を Terraform で定義していません。Terraform が持っているのはデータセット、バケット、Cloud Run Job、サービスアカウントと権限までで、データセットの中のテーブルには踏み込んでいません。
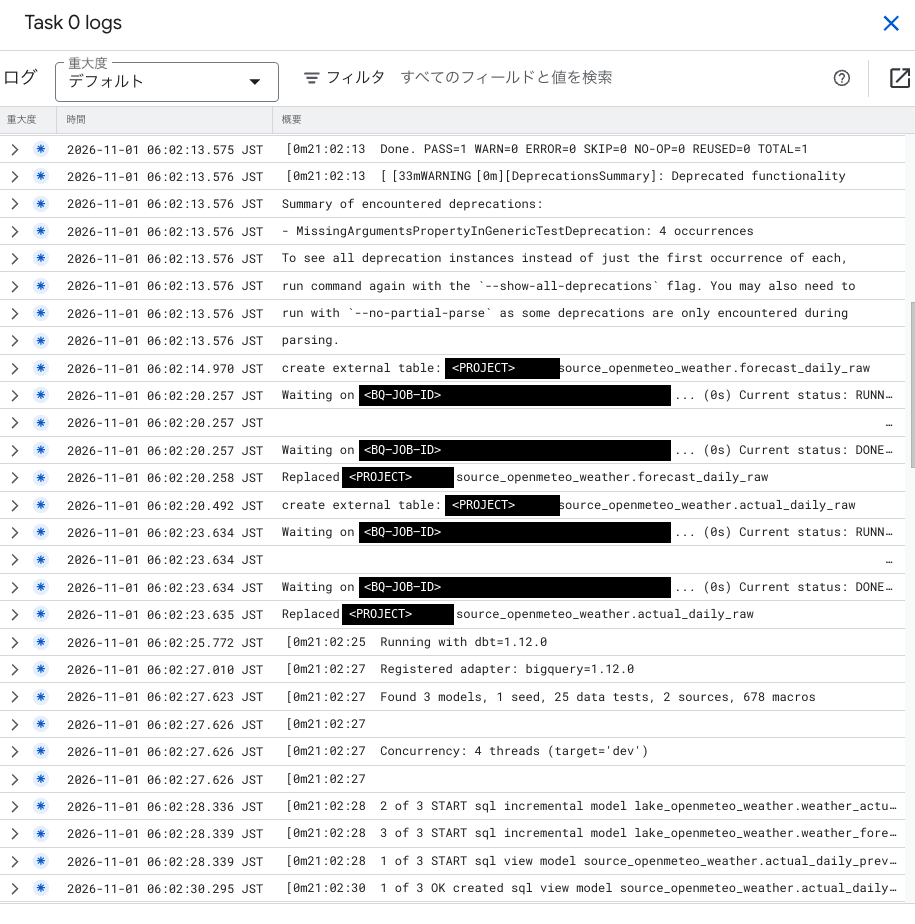
external table は、Job が起動したときにスクリプトで作っています。CREATE OR REPLACE なので、毎回流しても同じ結果になります。
create_external_table() {
	local table_name="$1"
	local columns="$2"
	local source_uri="$3"
	local hive_prefix="$4"
	local partition_columns="$5"
	local table_description="$6"

	bq query \
		--project_id="${PROJECT_ID}" \
		--location="${BQ_LOCATION}" \
		--nouse_legacy_sql \
		"CREATE OR REPLACE EXTERNAL TABLE \`${PROJECT_ID}.${SOURCE_DATASET}.${table_name}\`
    (
      ${columns}
    )
    WITH PARTITION COLUMNS (
      ${partition_columns}
    )
    OPTIONS (
      description = '${table_description}',
      format = 'NEWLINE_DELIMITED_JSON',
      uris = ['${source_uri}'],
      hive_partition_uri_prefix = '${hive_prefix}',
      ignore_unknown_values = true
    )"
}
呼び出す側は、テーブルごとにカラムの定義と GCS のパスを渡します。ignore_unknown_values を有効にしてあるので、API のレスポンスに知らないフィールドが増えても落ちません。WITH PARTITION COLUMNS に渡しているのが、前の節で触れた取得日の 1 段です。
Job の起動スクリプトでは、external table の作成を dbt run の前に挟んでいます。
uv run dbt deps --profiles-dir .
uv run dbt seed --profiles-dir .

"$SCRIPT_DIR/scripts/create_external_tables.sh"

uv run dbt run --profiles-dir .
uv run dbt test --profiles-dir .この構成には代償があります。bq コマンドを使うため、コンテナのベースイメージを Google Cloud CLI の入ったものにしています。dbt だけなら Python の軽いイメージで済むところです。external table を Terraform で定義すれば、この代償は無くなります。
Source層とLake層の分け方
Source は external table をそのまま指す層にして、重複を除いて書き込むのは Lake の層に寄せています。こう分けておくと、GCS の生データを触らずに変換だけ作り直せます。
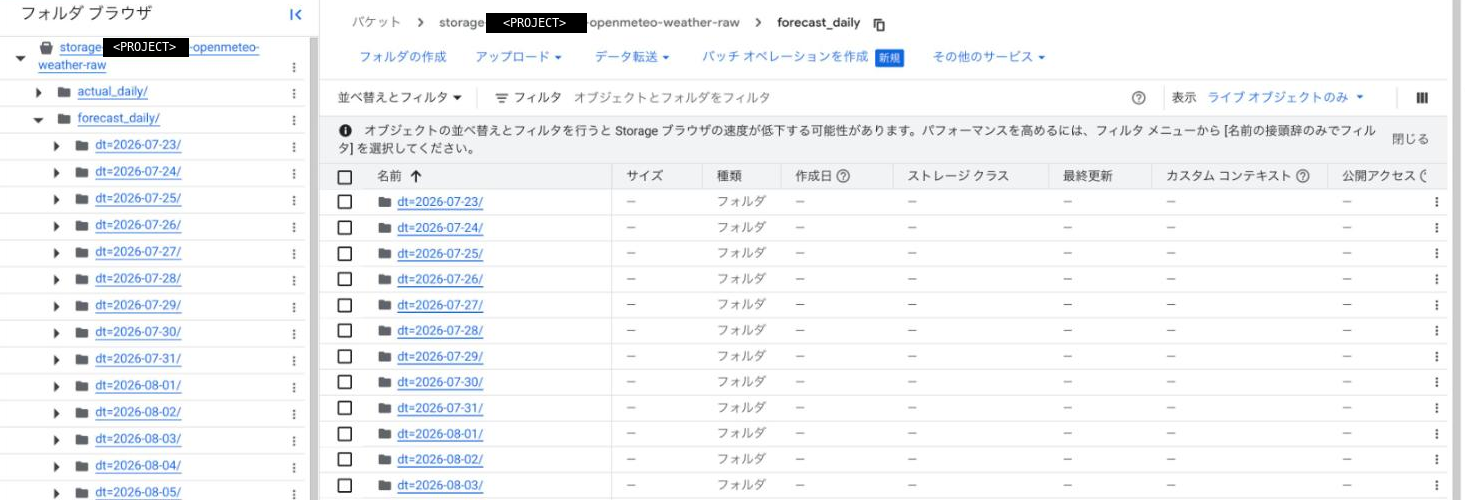
型は Source の時点で付けています。前の節の DDL に渡すカラムの定義で、数値は FLOAT64、日付は DATE、時刻は TIMESTAMP と宣言します。そのため、Lake のモデルに型変換は書いていません。
層ごとの作り方は、プロジェクトの設定で分けています。
models:
  dbt_openmeteo_weather:
    # schema.yml の description を BigQuery の table / column description に反映する。
    +persist_docs:
      relation: true
      columns: true
    source:
      +materialized: view
      +schema: "{{ env_var('SOURCE_DATASET', 'source_openmeteo_weather') }}"
    lake:
      +materialized: incremental
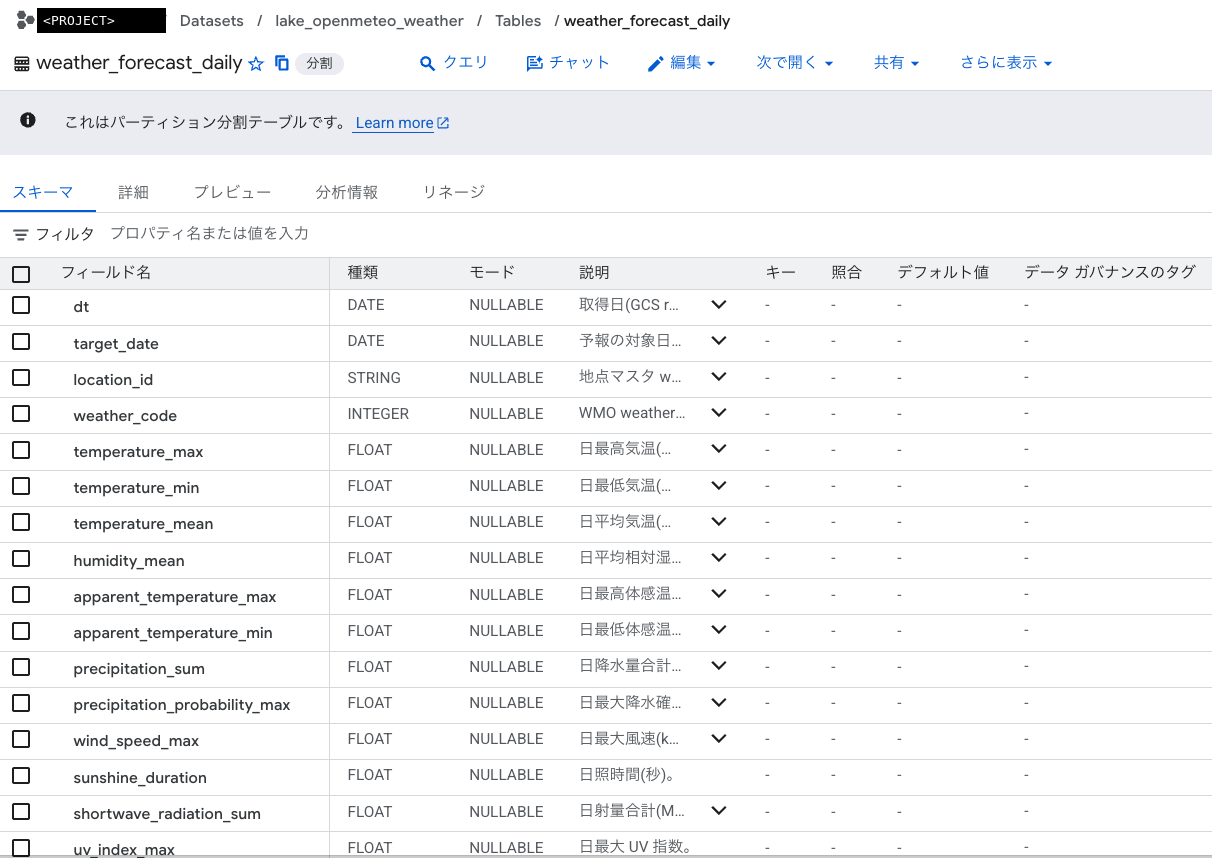
+persist_docs を有効にしてあるので、schema.yml に書いた説明が BigQuery のテーブルとカラムの説明として入ります。dbt が作るテーブルとカラムに説明を付ける運用にしているので、これが無いと BigQuery の画面側が空のままになります。
ただし、external table の説明はここでは入りません。dbt が作ったテーブルではないからです。external table のテーブルの説明は、前の節の DDL にある OPTIONS(description=...) で別途付けています。カラムの説明も DDL に書いていますが、BigQuery のスキーマ画面では空のままでした。説明を二重に持つので、変えるときは両方を直します。
mergeのunique_keyは収束か積み上げかを決める
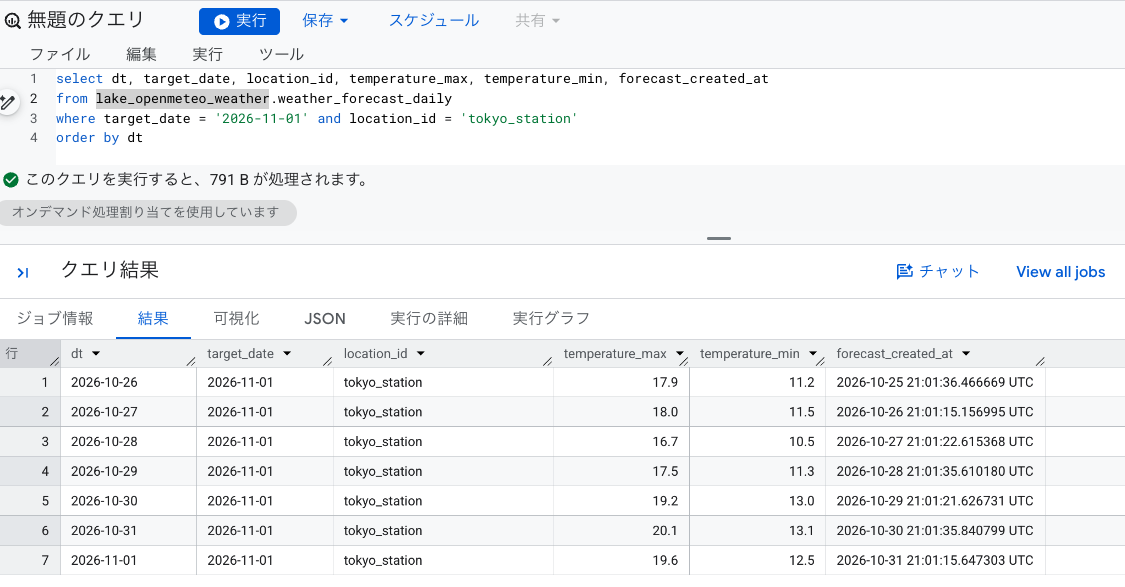
同じ incremental と merge でも、unique_key に取得日を入れるかどうかで意味が反転します。私のパイプラインには、反対向きのテーブルが 2 つ並んでいます。
ここで言う merge は、同じキーの行が来たら上書きし、無ければ追加する書き込み方です。何を同じキーと見なすかが unique_key です。
| テーブル | unique_key | 起きること |
| 確報 | 対象日 + 地点 | 1 日 1 行に収束する。取り直すたびに確定値へ寄っていく |
| 予報 | 取得日 + 対象日 + 地点 | 取得日ごとに履歴が積み上がる。同じ日に 2 回流しても増えない |
予報は「いつ時点の予報だったか」を残したいので、取得日をキーに入れます。確報は最新の確定値だけあればよいので、入れません。残したい履歴の単位を先に決めてから、キーを組み立ててください。
mergeに渡す前に1行へ絞る
生データに同じキーが複数あると、merge は「1 つの対象行に複数の元行が一致する」という理由で失敗します。直近の数日をまとめて取り直す運用にしていると、同じ対象日が複数の取得日のパーティションに入るので、必ず起きます。
対処は、モデルの中で最新の 1 行に絞ってから渡すことです。
{{ config(
    materialized='incremental',
    incremental_strategy='merge',
    unique_key=['date', 'location_id'],
    on_schema_change='sync_all_columns',
    partition_by={'field': 'date', 'data_type': 'date'},
    cluster_by=['location_id']
) }}

select
    `date`,
    location_id,
    temperature_max,
    temperature_min,
    fetched_at,
    dt
from {{ source('openmeteo_weather', 'actual_daily_raw') }}
where temperature_max is not null
  and temperature_min is not null
{% if is_incremental() %}
  and dt >= date_sub(current_date('Asia/Tokyo'), interval 12 day)
{% endif %}
qualify row_number() over (
    partition by `date`, location_id
    order by dt desc, fetched_at desc
) = 1
qualify で、対象日と地点の組ごとに最新の取得日の行だけを残しています。増分実行のときは読む取得日のパーティションも絞っているので、スキャン量も抑えられます。
mergeキーに取得時刻を入れない
unique_key に取得時刻を入れると、同じ日に 2 回流しただけで履歴が増えていきます。生データの側は同じパスを上書きするので何度流しても同じなのに、Lake の側だけが別のキーとして追加されていく形です。
履歴の粒度は取得日までにして、取得時刻は参考のカラムに留めます。私はカラムの説明にも「merge キーには使わない」と書き残しました。キーに使ってよいかどうかは、カラム名からは読み取れません。
動いているように見えて止まっているとき
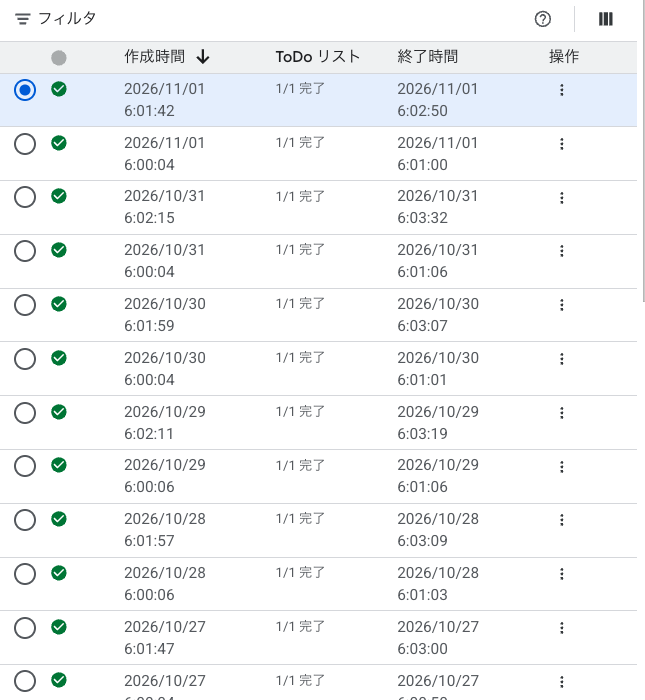
dbt が毎日成功していることは、入力が新しいことを意味しません。凍結された入力を変換し続けても、結果は成功で返ります。
私のパイプラインを棚卸ししたとき、取り込み側が 3 か月前に止まったまま、dbt だけが毎日成功している系列が 2 本ありました。実行履歴だけを見ていれば、どちらも健全に見えます。
| 層 | 最終更新 |
| 取り込み(GCS へ置く側) | 3 か月前で停止 |
| dbt(毎日実行) | 前日。成功 |
| 運用記録のテーブル | 3 か月前で停止 |
確かめ方は、ジョブの成否ではなく出力先の最終更新時刻を見ることです。BigQuery ならデータセットのメタ情報から、GCS ならオブジェクトのタイムスタンプから取れます。生死は層ごとに判定してください。
もう 1 つ、タイムアウトは入れ子にします。dbt 側のクエリのタイムアウトを短く、Cloud Run Job 側のタイムアウトを長くします。逆にすると、dbt が書き終わる前に Job が切れて、途中まで書いた状態で失敗します。私の構成では dbt 側を 1800 秒、Job 側を 3600 秒にしています。
まとめ
GCS に NDJSON を置き、取得日の 1 段だけでパーティションを切り、Source で型を付けて読み、Lake で重複を除いて書き込む。これが私の構成です。
- external table は Terraform で定義せず、Job の起動時にスクリプトで作る。代わりにコンテナのベースイメージが重くなる。
- パーティションの列名をファイルの中のカラムと重複させない。merge の前に最新の 1 行へ絞る。merge キーに取得時刻を入れない。
- テーブルを作る前に、残したい履歴の単位を決める。収束させたいなら対象日まで、積み上げたいなら取得日までをキーにする。
なお、BigQuery の管理画面の構成や external table の制約、dbt の設定名は変わります。実際に設定するときは、最新を公式ドキュメントで確認してください。