はじめに
API からデータを取って BigQuery に入れる処理は、自分で書くこともできますし、ETL ツールに寄せることもできます。本記事は後者を試した記録です。
dltHub が開発する Python のライブラリ dlt を、GitHub REST API で使いました。API からデータを取る処理を自分で書くと、抽出・スキーマ定義・増分取得・重複排除・中間ファイルの保存の 5 つを実装することになります。dlt はこれを宣言に置き換えます。宣言とは、取得の手順を 1 行ずつ書く代わりに、どこから何をどう取るかを設定として書くことです。結論は、この 5 つすべてが宣言だけで済んだということです。同じ処理を素の Python でも書いていたので、何が置き換わったかをそのまま比べられます。
本記事のまとめ
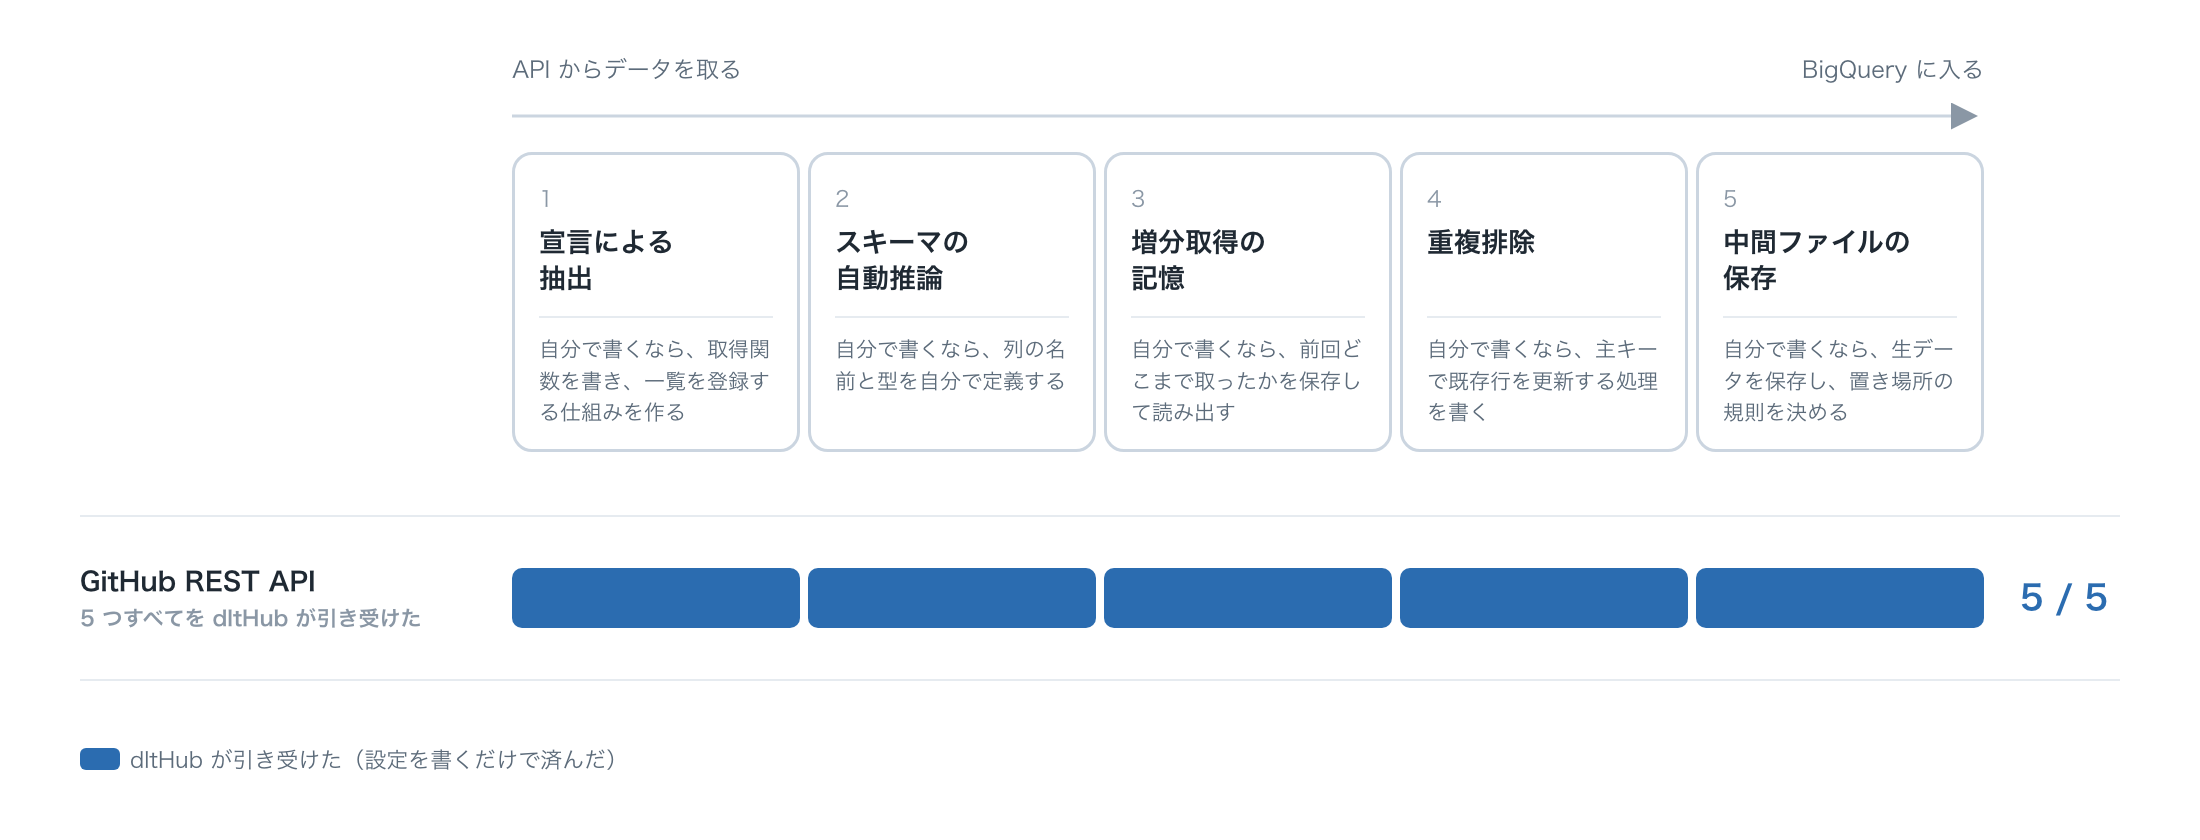
- 自分で書くと実装することになる処理は次の 5 つで、これが宣言に置き換わるかを数える
- 宣言による抽出
- スキーマの自動推論
- 増分取得の記憶
- 重複排除
- 中間ファイルの保存
- GitHub REST API では 5 つすべてが置き換わり、列の定義を 1 行も書かずに済んだ
- エラーが出ないまま 0 件で成功終了する失敗があり、ログの行数を見ないと気づけない
- 選ぶ前に答える質問は 2 つ。宣言で取得を書けるかと、日付を指定した取り直しを運用で使うかである
dltHubとは何か
dlt が Python のライブラリ名で、dltHub は開発元の会社名です。検索すると両方の表記が出てきますが、インストールするパッケージは dlt です。公式ドキュメントは「dlt is an open-source Python library that loads data from various, often messy data sources into well-structured datasets.」と自己紹介しています(dlt 公式ドキュメント、配布は PyPI の dlt)。
公式ドキュメントは dlt の役割を「extract, load, inspect and transform」と書いています。抽出と読み込みだけの道具ではありません。増分取得、スキーマの自動進化(あとから列が増えたときの追従)、スキーマとデータの契約、取り込んだデータの確認、変換までを備えています。
本記事が扱うのは抽出と読み込みです。変換は dbt に任せているので、dlt の変換機能は使っていません。dbt は、取り込んだあとの変換を SQL で書いて管理するツールです。
そこでこの記事では、自分で API 取得を書くと実装することになる 5 つを数えます。dlt の機能全部ではありません。
- 宣言による抽出。自分で書くなら、エンドポイントごとに取得関数を書き、一覧を登録する仕組みを作る
- スキーマの自動推論。自分で書くなら、レスポンスの形を読んで列の名前と型を定義する
- 増分取得の記憶。自分で書くなら、前回どこまで取ったかを保存し、次回読み出す
- 重複排除。自分で書くなら、主キーで既存行を更新する処理を書く。面倒なので後回しにしがち
- 中間ファイルの保存。自分で書くなら、生データを JSONL などで保存し、置き場所の規則を決める
5 つは独立していて、宣言に置き換わる数が多いほど dlt を使う利点が大きくなります。置き換わる数が少ない API では、ライブラリを挟んでも自分で書く部分がそのまま残ります。
GitHub APIでは5つすべてをdltHubが引き受けた
GitHub の issues と pull requests を取る処理では、5 つすべてが宣言に置き換わりました。同じ API を素の Python でも書いていたので、何が置き換わったかをそのまま比べられます。
次のコードです。識別子は伏せ、構造は実物のままにしています。
return rest_api_source(
    {
        "client": {
            "base_url": "https://api.github.com",
            "auth": {"type": "bearer", "token": token},
            "headers": {"X-GitHub-Api-Version": "2022-11-28"},
            "paginator": {"type": "header_link"},
        },
        "resource_defaults": {
            "primary_key": "id",
            "write_disposition": "merge",
            "endpoint": {"params": {"per_page": 100}},
        },
        "resources": [
            {
                "name": "issues",
                "endpoint": {
                    "path": f"/repos/{owner}/{repo}/issues",
                    "params": {
                        "state": "all",
                        "sort": "updated",
                        "direction": "asc",
                        "since": "{incremental.start_value}",
                    },
                    "incremental": {
                        "cursor_path": "updated_at",
                        "initial_value": initial_since,
                    },
                },
            },
        ],
    }
)大事なのは、列の定義が 1 行も無いことです。レスポンスの形は dlt が読んで決めます。入れ子になっている部分は子テーブルに分けられ、そこまで自動です。
素の Python 版と並べたのが次の表です。左が自分で実装していた処理、右がそれを置き換えた dlt の指定です。
| 自分で書いていたもの | dlt での置き換え |
| 前回位置を Cloud Storage の JSON に保存する処理 | incremental の宣言。記憶は BigQuery 側の管理テーブルに入る |
| ページをたどる処理 | "paginator": {"type": "header_link"} の 1 行 |
| エンドポイントの登録と振り分け | resources 配列の宣言 |
| JSONL を gzip で書き出す処理 | staging の指定と layout の 1 行 |
| dataclass による列定義の手書き | 自動推論。子テーブルへの分割まで自動 |
| 重複排除(素の Python 版では作っていなかった) | write_disposition: "merge" と primary_key |
行数は素の Python 版が 1,553 行、dlt 版が 162 行でした。ただし取得範囲が違います。素の Python 版は 5 エンドポイントを複数リポジトリに対して走査し、期間指定の取り直しにも対応しています。dlt 版は 2 エンドポイント・1 リポジトリ・増分取得のみです。ですから「10 分の 1 になる」とは言えません。言えるのは、同じ機能を自分で書いていた部分が宣言に置き換わったということだけです。
増分取得が効いているかは、2 回流して確かめました。
| 実行 | リクエスト数 | 取得行数 |
| 1 回目 | 10 | issues 404 行 / pull requests 404 行 |
| 2 回目(続けて実行) | 2 | 0 件。読み込みの段階に入らず終了 |
| 記憶を持たない別名で全件再取得 | 10 | 404 行のまま(増えない) |
2 回目のログには、1 回目に取れた最大の updated_at がそのまま since として入っていました。宣言した前回位置が本当に使われていたということです。3 行目は重複排除の確認です。記憶を持たない別名から全件入れ直しても行数は増えませんでした。
ただし、宣言で書けることと、狙いどおり効かせられることは別でした。書き方はエンドポイントごとに違います。/issues は since を受け取るので、前回位置をクエリに埋めて取得量自体を減らせます。/pulls には since がないため、更新日時の降順に並べ、古い行に当たった時点でページ送りを打ち切る指定が必要でした。
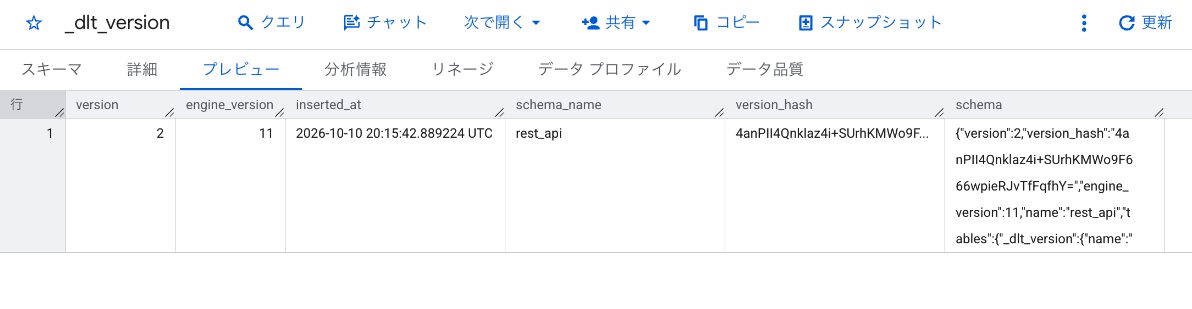
中間ファイルの保存先も宣言します。ここには既定値の落とし穴があり、次の節で扱います。
return dlt.pipeline(
    pipeline_name=PIPELINE_NAME,
    destination=dlt.destinations.bigquery(
        location="asia-northeast1",
        truncate_tables_on_staging_destination_before_load=False,
    ),
    staging=filesystem(
        bucket_url=BUCKET_URL,
        layout="{table_name}/dt={YYYY}-{MM}-{DD}/{load_id}.{file_id}.{ext}",
    ),
    dataset_name=DATASET_NAME,
)
エラーにならないまま失敗することが2つある
宣言したのに効いていない状態が 2 つあります。どちらもエラーが出ないまま成功で終わります。困るのは効いていないことより、気づけないことのほうです。私はどちらも実際に踏みました。
前回位置が残っていて0件で成功終了する
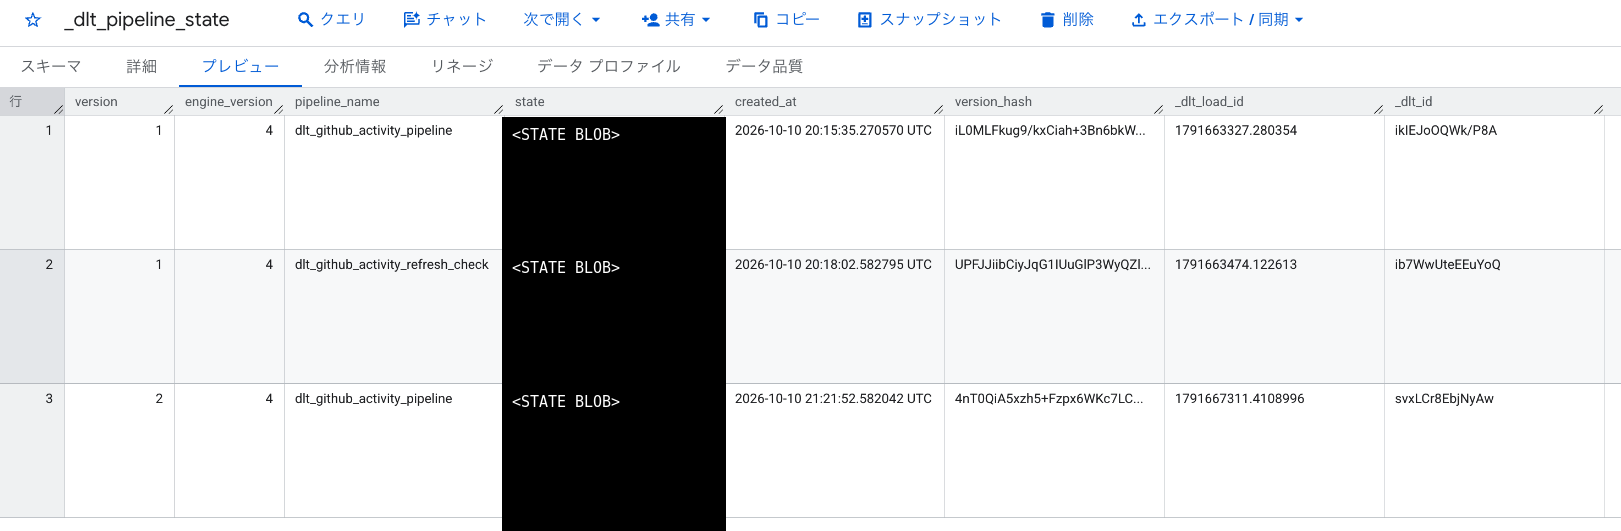
増分取得の記憶が残っていると、API は正常でデータも取れているのに、BigQuery には 0 件しか入りません。dlt が「前回と同じところまで取ってある」と判断するためです。
私は最初、API 側を疑いました。記憶を消すコマンドを実行したところ「リセットする対象が見つからない」と返ってきたので、記憶は残っていないと判断したからです。実際には残っていました。コマンドの返り値だけでは、記憶があるかどうかを判断できません。
原因が分かったあとは、記憶を消して流し直し復旧しました。以降は実行ログに実際の行数が出ているかを見ています。読み込み対象が 0 件という表示で終わっていれば、成功していても取れていません。
その行数を出すところでも 2 回つまずきました。2 回目のエラーで原因が分かりました。
AttributeError: 'ParsedLoadJobFileName' object has no attribute 'items_count'読み込み結果の指標は読み込み ID をキーに持っているため、テーブルごとの件数は取れません。テーブル別に数えるなら、整形の段階で記録される行数を見ます。
保存先によってはmergeが追記に変わる
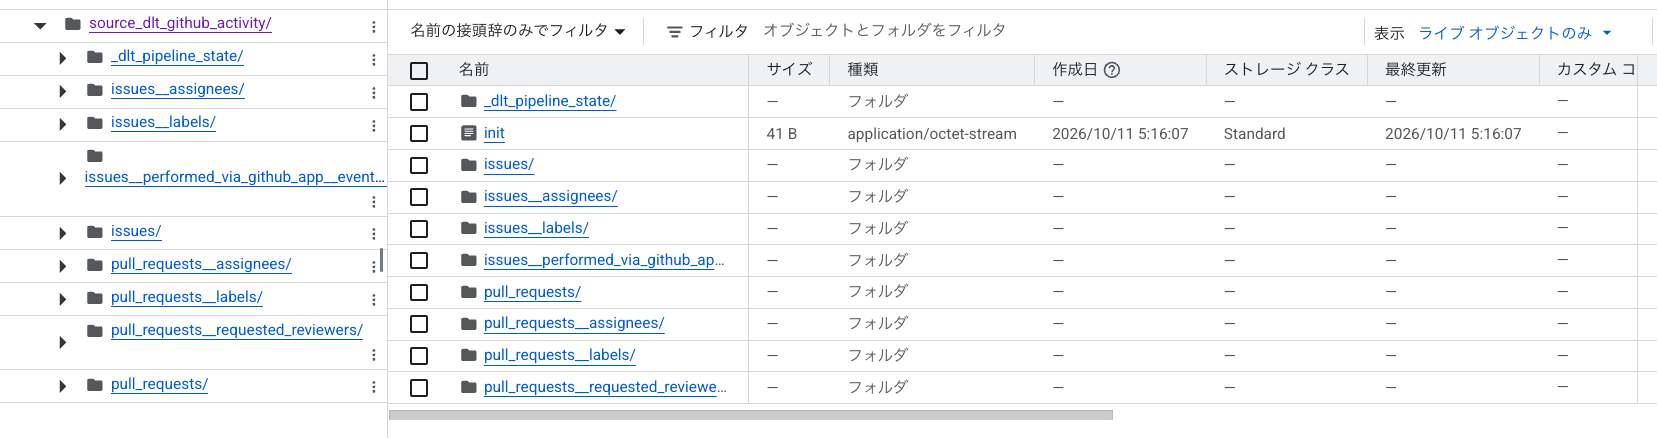
最終的な保存先をクラウドストレージにすると、重複排除の指定が追記に置き換わります。警告は出ますがエラーにはならないため、同じ主キーの行が増え続けます。
もう 1 つ、既定値のまま使うと中間ファイルが消える点にも注意が必要です。中間ファイルを次の読み込み前に削除する設定が既定で有効になっているので、生データを残したいなら無効にします。前の節のコードで truncate_tables_on_staging_destination_before_load を明示的に False にしているのはこのためです。
自前で書くか、dltHubに任せるか
選ぶ前に答えを出すべき質問は次の 2 つです。この 2 つで、たいていの判断は付きます。
- 宣言で取得を書けるか
- 日付を指定した取り直しを運用で使うか
その前に、使ってみて手間だと感じた点を挙げます。次の 7 つです。
- 効かせ方がエンドポイントごとに違う。宣言で書けること自体は変わらないが、どう書けば効くかは API の仕様に引きずられる
- 既定値のままだと中間ファイルが消える。生データを残す前提なら、最初に設定を変える必要がある
- 保存先の選択が重複排除を縛る。最終的な保存先をクラウドストレージにすると追記に落ちる
- 何件入ったかが分かりにくい。読み込み結果からはテーブル別の行数が取れず、型を指定していない列について警告が大量に出る
- 期間を指定した取り直しが素直に書けない。記憶を操作するか、別の名前で流すことが前提になる
- BigQuery 側の列の形が変わる。入れ子が二重アンダースコアで平たくされ、dlt の管理用の列が増える。既存の変換処理をそのままでは差し替えられない
- バージョンの固定が事実上必須。既定値が挙動を左右するので、上げるときは既定値の変更を確認する
そのうえで、選ぶ側の条件です。
- 宣言に収まる REST API である
- あとから更新される行があり、重複排除が要る
- 前回位置になる項目が 1 つに決まる
- レスポンスが入れ子で、スキーマ推論の利得がある
- 取得と同時に BigQuery まで入れたい
選ばない側の条件です。
- 生データの置き場所やファイル名に固有の決まりがある
- 日付を指定した取り直しを運用で多く使う
- レスポンスが平たく、スキーマ推論の利得が無い
既成の定義があれば安心、ではありません。dlt には主要なサービス向けの定義があらかじめ用意されていますが、書き込み方法が固定されていることがあり、全件置き換え専用のものでは増分取得と重複排除を同時に使えません。GitHub で私が使ったのも、既成の定義ではなく自分で書いた宣言でした。
まとめ
dltHub に任せるかどうかは、自分で書いていた 5 つのうち、何個が宣言に置き換わるかで決まります。GitHub REST API では 5 つすべてが置き換わりました。
- 列の定義を 1 行も書かずに、入れ子のレスポンスが子テーブルに分かれるところまで自動で済んだ。ただし行数の差は取得範囲が違うので、倍率としては読めない
- 注意点は、エラーにならない失敗が 2 つあること。前回位置が残って 0 件で成功終了する件と、保存先によって重複排除が追記に変わる件である
- 次に見るのは自分の API。宣言で取得を書けるか、日付指定の取り直しを使うかを先に確かめる
なお、ここまでの内容は dlt[bigquery,duckdb,filesystem]==1.31.0 で確かめたものです。保存先の対応状況、既成の定義の有無、設定の既定値はバージョンによって変わります。実際に使うときは、最新を公式ドキュメントで確認してください。